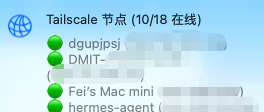
我自己平时主力工作流跑在 Mac mini 、MacBook Pro 、iPhone 和几台云端沙箱上。跨设备互联全靠 Tailscale ,网络入口则统一由 Surge Mac 和 Surge iOS 接管。前阵子去 Tailscale 后台查设备状态,发现机器列表不知不觉膨胀到了 36 台——光 mac-mini-surge 就从 -1 一路排到了 -13,iphone-surge 也攒了 6 个编号,其中整整 18 台都是离线几个月的“幽灵节点”。
工具链自动化只管“连得上”却不管回收状态脏数据,省下的那点配置时间,迟早变成日常排障的负担。我不愿意每次为了确认哪台机器掉线专门打开网页后台翻半天,干脆写了一个跑在 Surge 仪表盘里的 Tailscale 状态面板模块,顺手把同名离线幽灵节点的去重和清理接进了日常刷新流程。目前代码已整理开源在 GitHub: https://github.com/flylocus/surge-tailscale-panel
为什么要做
用过 Surge 原生 [Tailscale] 模块的朋友大概都遇到过同一件烦心事。每当客户端配置重载或重新握手认证,Tailscale 控制面很容易在同一 hostname 下派生出带 -1、-2 递增后缀的新设备,旧节点就成了永远离线的僵尸记录。再叠加手机端巡检的几个老毛病,日常体验非常割裂:
- 真假离线混杂:18 台真实设备和 18 个历史幽灵节点混在同一个列表里。手机上看一眼到底是家里 Mac mini 掉了,还是几个月前的旧编号离线,每次都要人工肉眼过滤。
- 面板空间寸土寸金:Surge 仪表盘卡片高度很有限。十几台设备全列出来会把整个主界面撑得极长,真正需要盯的核心节点反而被淹没。
- 现成脚本在 JavaScriptCore 下水土不服:社区里不少早期脚本直接拿浏览器环境的 API 写参数解析和 Base64 编码,放到 Surge 的原生 JavaScriptCore 引擎里经常静默报错,面板一直转圈加载不出来。
核心实现
整个项目保持零外部依赖,只由两个核心文件组成。所有逻辑都在本地 Surge 脚本引擎与 Tailscale 官方 API v2 之间直接完成:
- **
Tailscale-Panel.sgmodule**:定义 Surge[Panel]卡片(默认 300 秒刷新一次)与[Script]参数模板,将组织名、密钥、展示数量上限、去重开关通过$argument传入脚本。 - **
tailscale-panel.js**:全量采用原生 ES5 / JavaScriptCore 语法编写,通过BearerToken 请求GET /api/v2/tailnet/{tailnet}/devices?fields=all获取完整设备元数据。 - 双重去重与安全回收管线:第一层默认在面板渲染时隐藏同组旧离线节点(
HIDE_DUP:true)。第二层在用户显式开启云端清理(CLEAN_DUP:true)时,对确认无误的旧幽灵节点发起DELETE /api/v2/device/{id}回收,等全部 HTTP 状态码确认返回2xx后再汇总到面板标题。
日常怎么用
如果是在 Surge 本地或 iCloud Drive 配置目录使用,把 Tailscale-Panel.sgmodule 和 tailscale-panel.js 放进 Documents/ 目录即可。如果习惯在手机端直接通过 URL 订阅模块,只需把模块参数里的 SCRIPT_PATH 指向仓库里的脚本 Raw 链接:
#!arguments=TAILNET:-,API_KEY:tskey-api-xxx,MAX_VISIBLE:5,HIDE_DUP:true,CLEAN_DUP:false,SCRIPT_PATH:tailscale-panel.js
平时最常用的三个控制参数如下:
MAX_VISIBLE( 1–5 可调,默认 5 ):控制在面板卡片里最多展示几行设备。脚本会优先把在线节点排在前面,超出上限的节点自动折叠成底部一行… 其余 N 个节点已折叠,而卡片标题依然保留完整的在线数/总数统计。HIDE_DUP(默认true):在面板里自动隐藏同一设备的旧离线编号,不改动云端数据。哪怕只给只读权限(devices:core:read),面板也能保持清爽。CLEAN_DUP(默认false):开启后会在刷新面板时顺手调用删除接口,把云端的同名旧离线节点清理掉(需要devices:core写权限)。
实际运行数据
这套脚本目前在我自己的 Surge Mac 和 Surge iOS 上当主力跑着。面板定时每 5 分钟刷新一次,单次 API 请求加渲染耗时在 200ms 左右:
- 幽灵节点清理效果:首次开启清理跑了一轮后,我账号下堆积的 18 个重复离线节点(包括 5 个
iphone-surge-*、12 个mac-mini-surge-*和 1 个旧shenfeimacbook-pro)一次性全部返回HTTP 200清理干净,机器列表从 36 台缩减到真实的 18 台( 11 台常驻在线、7 台独立物理设备离线)。 - 面板可读性:设置
MAX_VISIBLE=5后,原本需要滚屏两页的 18 台设备被固定收敛在 6 行以内。打开手机一眼就能看到总数11/18 在线以及核心节点的 Tailscale 内网 IP 。
踩过的坑
这个状态面板在打磨到能放心开源之前,前前后后踩了四个挺典型的工程坑:
- 内联 Base64 脚本的截断与规范陷阱:最早我尝试把 JS 代码转成
data:text/javascript;base64,...塞进.sgmodule里做单文件分发。结果长串 Base64 极易在编辑复制时截断导致语法未闭合,核对 Surge 官方文档才确认script-path只正式支持本地路径和http(s)://链接,最终老老实实改回了外置脚本加SCRIPT_PATH参数化。 - JavaScriptCore 缺少浏览器 DOM API:初版代码里顺手写了
new URLSearchParams($argument)和btoa(),结果 Surge 的脚本环境并不是完整浏览器,直接触发变量未定义异常。后来我手写了带try/catch(防孤立%触发URIError)和Object.create(null)(防主机名叫toString污染原型链)的参数解析器,认证也直接改用 Tailscale API v2 原生支持的Bearer头,彻底甩掉了 Base64 编码。 - 防止误伤真实同名或编号服务器的身份守卫:一开始只按“去掉末尾
-数字后名称相同”来判重。做边界测试时发现,如果有人原本就把两台不同服务器命名为node-1和node-2,离线的一台就会被误判成重复节点删掉。为此我加了严苛的复合键守卫:只有当节点同时具备完整的id、name、hostname、os、user五项身份字段,且去后缀的基础名与hostname完全一致、组内确实存在自动递增后缀节点时,才允许进入去重管线。 - 在线状态推断与异步删除假阳性:初版为了兼容旧字段,写了一条“如果没返回在线布尔值,只要
lastSeen在 10 分钟内就算在线”的回退逻辑,并且发出异步$httpClient.delete后不看回调就直接显示“已清理”。后来用本地 Codex 做安全审计时揪出了两个高危漏洞:万一 API 漏返回状态字段,刚离线不到 10 分钟的节点会被当成“已有在线节点”的证据去触发同组其他节点删除;而只读 Token 调删除返回403时面板还会报喜不报忧。最终版本彻底砍掉了时间戳猜在线的逻辑,严格只认 API 明确返回的connectedToControl布尔值,且必须等所有删除回调确认 HTTP 状态码后才区分显示“已清理”或“清理失败(已隐藏)”。
下一步
目前这个模块还有一个已知限制。如果追求最小权限,使用 Tailscale 的 OAuth Client 或 Trust Credentials 签发细粒度只读令牌(devices:core:read),这类短期令牌通常 1 小时就会过期;受限于 Surge 面板脚本的无状态执行模型,脚本内还没有做 OAuth 自动续期,长期挂着跑还是得用个人 API Access Token 或者靠外部定时任务轮换。接下来我打算试试利用 Surge 的 $persistentStore,把 OAuth client_id 和 client_secret 的本地换票续期也封进去,这样就不用在模块参数里放长效 Token 了。
仓库地址: https://github.com/flylocus/surge-tailscale-panel (附带了默认英文和简体中文双语文档)。平时也在用 Surge 跑 Tailscale 组网的朋友欢迎拿去试试,有更好的幽灵节点治理思路也欢迎交流。


 Select Language